
Smart Factory Insight (スマート・ファクトリー・インサイト)
SFIができること。
入れるものは、いつものCSVと波形。返るのは、目標に届くための条件セット。
50種のアルゴリズムを並列で走らせ、推奨スコア順に上位3〜5つを自動選定。
現場データの取り込み
- 生産CSV
- PLCログ
- 検査波形
- Excel帳票
- センサ時系列
ドラッグ&ドロップで登録。整形コード不要。
- 波形から5カテゴリ33種類の特徴量を切り出す
- 300項目から18項目に絞る
- 50種アルゴリズムを並列で走らせ、推奨スコア順に上位3〜5つを自動選定する
- そのモデルの上で、目標から逆算して条件を組み立てる
- 温度 178℃ 前後
- 時間 42秒 前後
- 圧力 0.32MPa
── 目標歩留 90% に届かせる条件セット。
具体的な効果、2つの軸で。
50種のアルゴリズムを一度に走らせ、精度・速度・説明性で並べ替える。
波形から33種類の特徴量を切り出す処理を、ブロック1つに置き換える。
SFIの、数字。
機能を4つの数字で示す。抽象的な効果ではなく、根拠のある実数で。
分類 15 / 回帰 19 / 異常予知 5 / クラスタリング 11
初期費用不要 / 1テーマ・1ラインから
Apache Arrow + Rust / 数百万行のCSVをそのまま扱う
プロセス条件提案方法(Backcast)
5候補推薦 か、全並列 か。
──使い方は2つ。
5候補を並列比較する。
SFIがデータの特性から 分類15 / 回帰19 の中から5候補を推薦。この5つを並列学習して精度比較。
推薦精度 ≒ 1位の 9割程度。時短で概ね正解にたどり着く。
全アルゴを同時学習する。
回帰 19全種/分類 15全種 を並列学習。時間はかかるが、最確実。監査・報告向け。
1位を100%当てに行く。結果は監査対応の一次資料に。
現場データが活きない、
3つの壁。
なぜ「解析しよう」で止まるのか。原因は精神論ではなく、3つの物理的な壁にある。
溜めているが、
使えていない。
CSVでは残る。しかし月次集計止まり。「何が効いているか」の判断には結びつかない。
製造業で蓄積されるデータのうち、意思決定に反映されないまま眠るデータの推定比率。
データサイエンティストが、
そもそも採れない。
製造現場の業務を理解し、機械学習も分かる人材は、東京都心でも競合する少人数の椅子取り。
製造業DX人材の年収レンジ。中堅企業では確保が難しく、確保できても定着が別の課題。
解析の一連の処理が
サイロ化している。
データ取得→クレンジング→項目選択→学習→評価→逆算→レポート。各工程が別ツール・別担当で、痕跡も手順も繋がらない。
突き合わせ3日+整形&確認2日。SFIはこの一連の処理を1枚のキャンバスに統合する。
カンとコツを、
後世に残す。
「脱泡後粘度は 700 が良いのか、
それとも 900 が良いのか?」
── この判断は、熟練者の長年の経験と直感に支えられてきた。
技能継承の主な手段が、「高齢者に居続けてもらう」。
JILPT調査で、技能継承策の最多回答は「再雇用・勤務延長で高年齢従業員に継続勤務してもらう」。仕組み化ではなく個人依存の先送りが常態化している。
技能継承策として「高年齢従業員の継続勤務」を挙げる製造業事業所(最多)
What tacit knowledge holds ── and how we honor it
熟練者の直感を
数値で裏付ける
「この項目が大事」という感覚を、寄与度・SN比で確かめる。
判断の根拠を
標準化する
熟練者が見ていた基準をモデルに埋め込み、誰でも再現できる形に。
知見を、
引き継ぐ形にする
退職してもノウハウは会社に残る。同じ判断を、誰もができるように。
SFIの、画面。
左パネルからブロックを選び、キャンバス上で接続していくことで、データ解析の一連のパイプラインが完成する。
コードは書かない。キャンバスそのものが、実行可能な解析手順書になる。
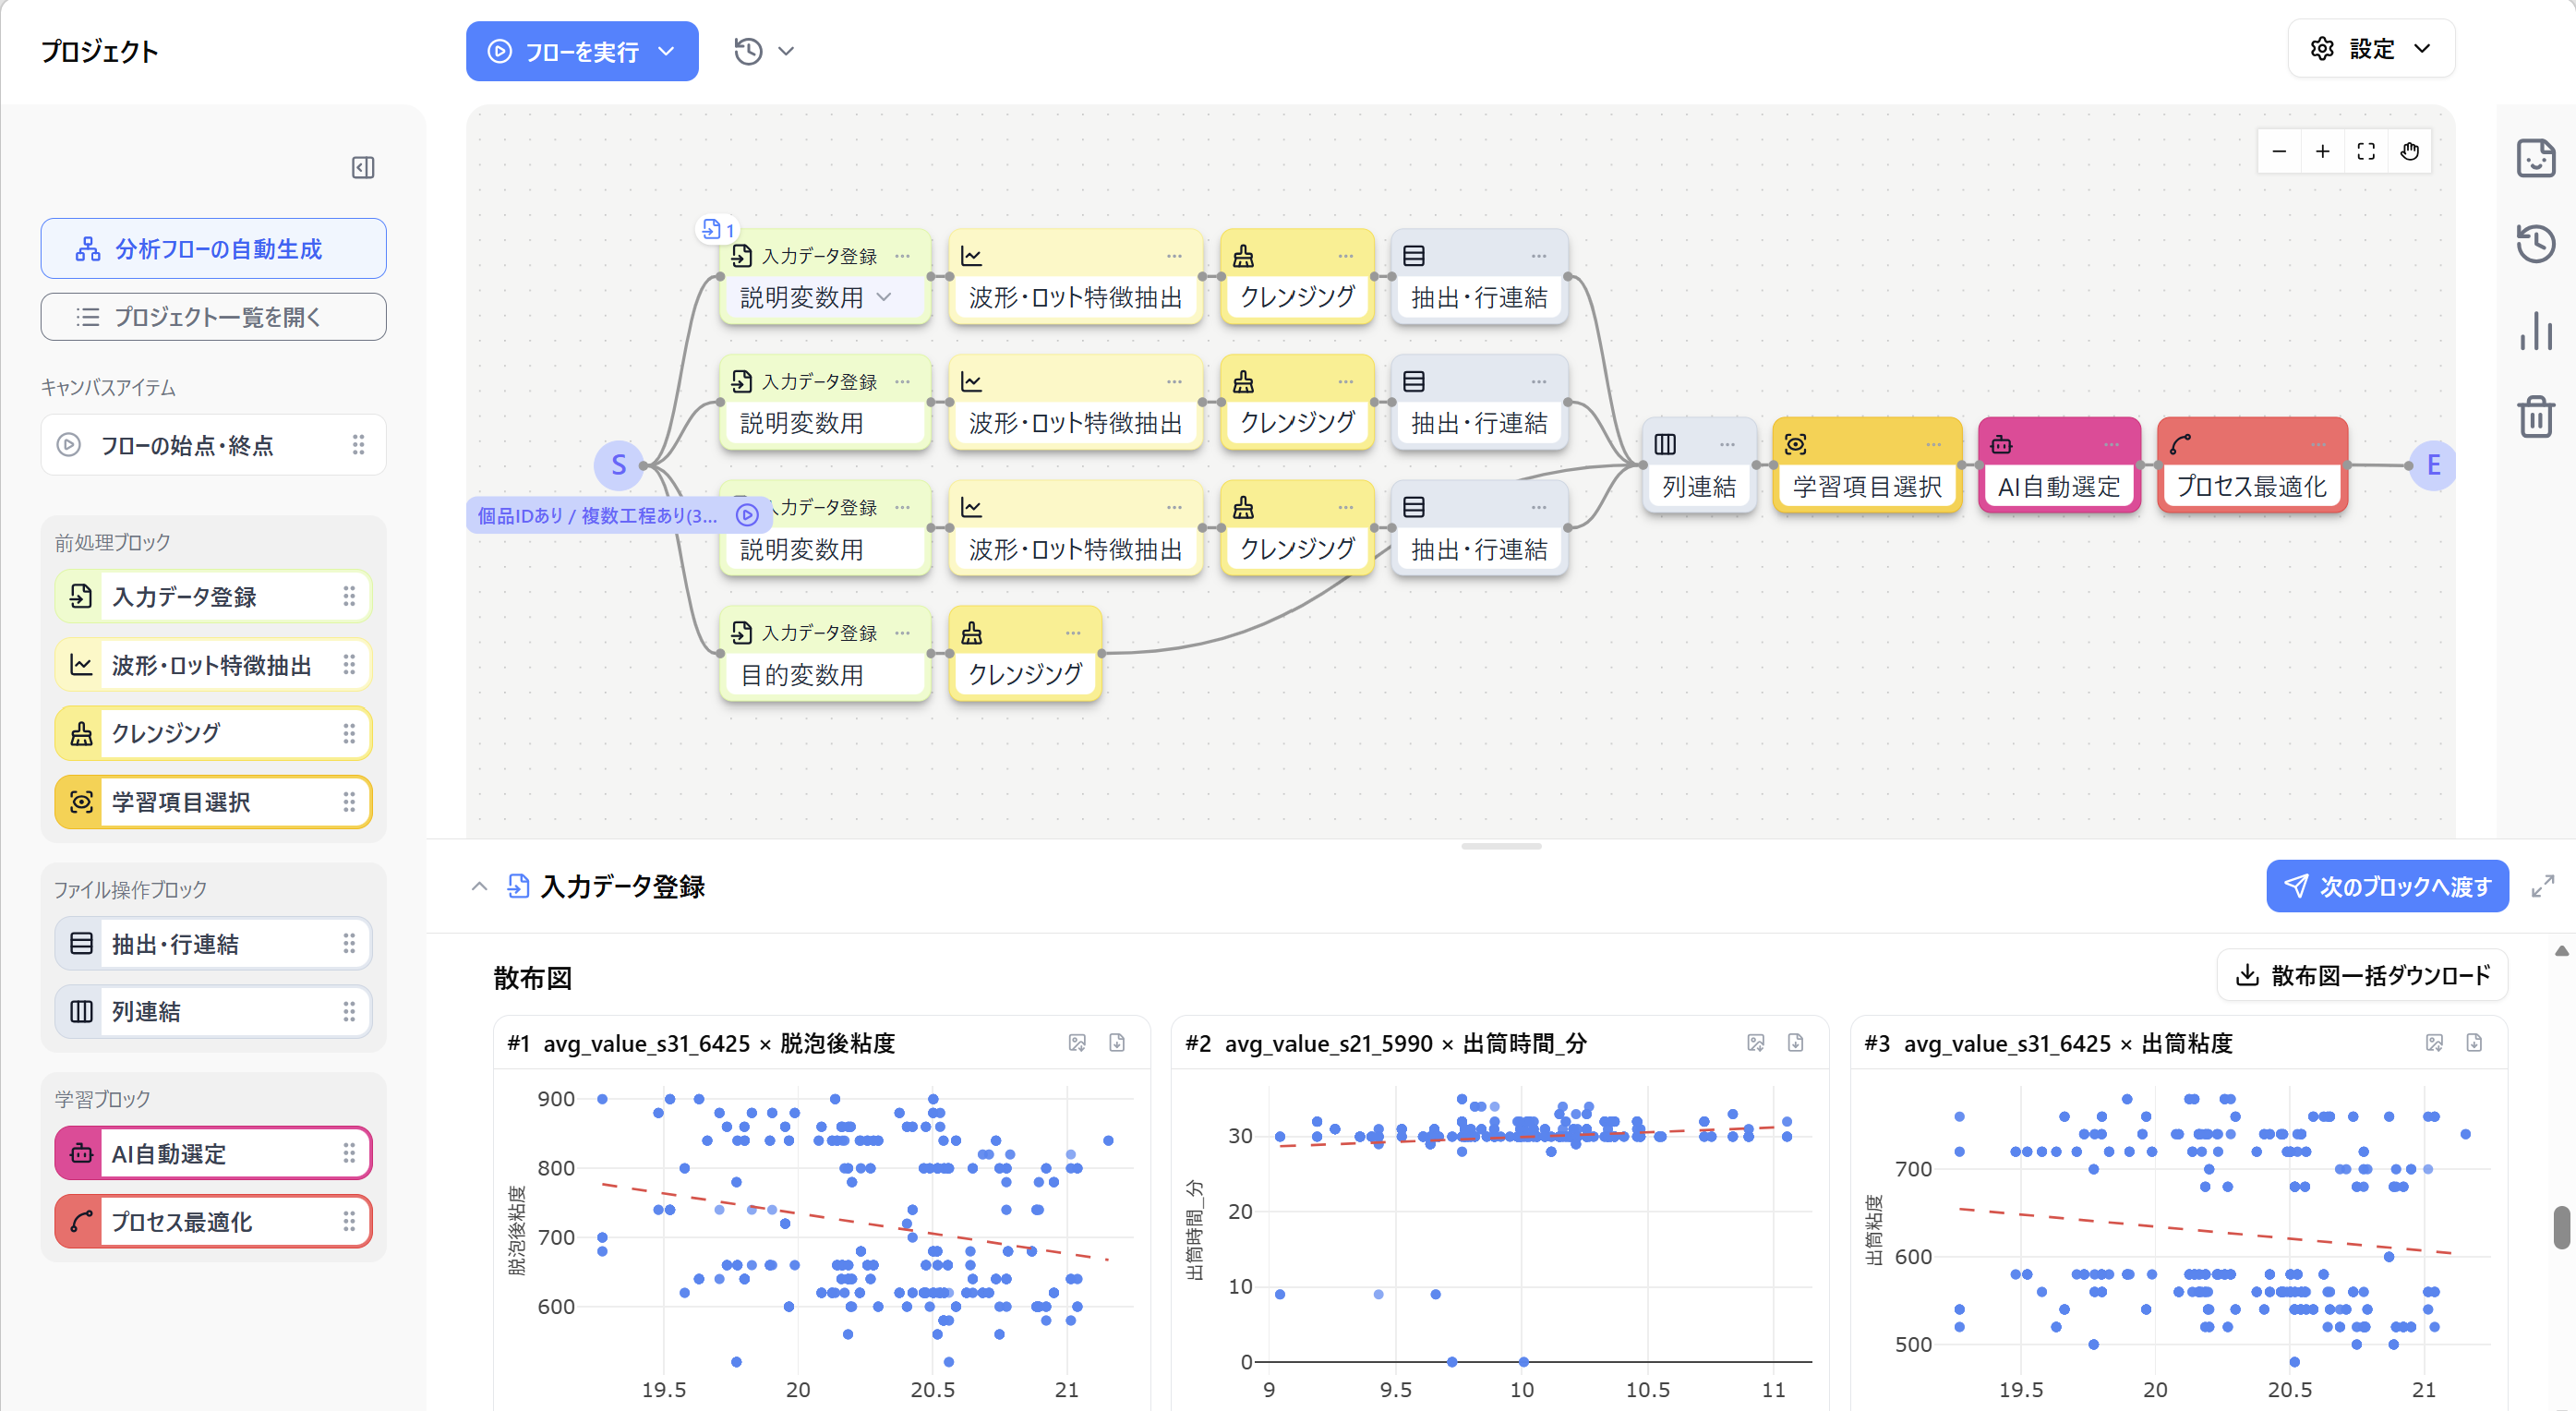
左列から
ブロックを選ぶ
波形抽出/クレンジング/学習項目選択/AI選定 ── 全9種類。
キャンバスで
線をつなぐ
出力ポートから入力ポートへドラッグ。処理順序が視覚的に固定される。
パイプラインを
実行する
前処理→項目診断→AI学習→逆算→レポートまでを一気通貫で実行。
コードを書かずに、データ解析の一連のパイプラインをキャンバス上で組み立て、そのまま実行・見える化する。
4つのコアで、
何をするか。
SFIの機能は、4つの動詞に集約される。この後 P.09〜P.12 で1つずつ具体的に示す。
波形から33種類の
特徴量を切り出す。
- INPUT
- センサの生波形(数百万点でも可)
- OUTPUT
- 5カテゴリ33種類(統計/変化/周波数/包絡/過渡)
前処理Python 200行 → ブロック 1つ
学習させる前に、
項目を診断する。
- INPUT
- 全項目のデータ
- OUTPUT
- SN比・尖度・歪度などの定量診断
品質工学のエッセンスをブロックに。タグチ手法の智慧。
分類15/回帰19の中から、
データに合うモデルを
自動推薦・選定する。
- INPUT
- 整えたデータ(目的変数と説明変数)
- OUTPUT
- 5候補推薦→並列学習→精度・寄与度で比較
MODE A 5候補推薦(時短)/MODE B 全並列(確実)
その予測モデルの上で、
目標から逆算して
条件セットを組み立てる。
- INPUT
- 目標歩留 90%
- OUTPUT
- 温度178℃/時間42秒/圧力0.32MPa
特願 2026-116053 / プロセス条件提案方法
見て、確かめる。
可視化レイヤー。
Visualization Layer ─ 6 chart types with statistics panel
どのブロックの出力も、そのまま6種類の可視化+基本統計パネルで見られる。
分布・時系列・相関の3視点で、現場が判断できる形に変換する。
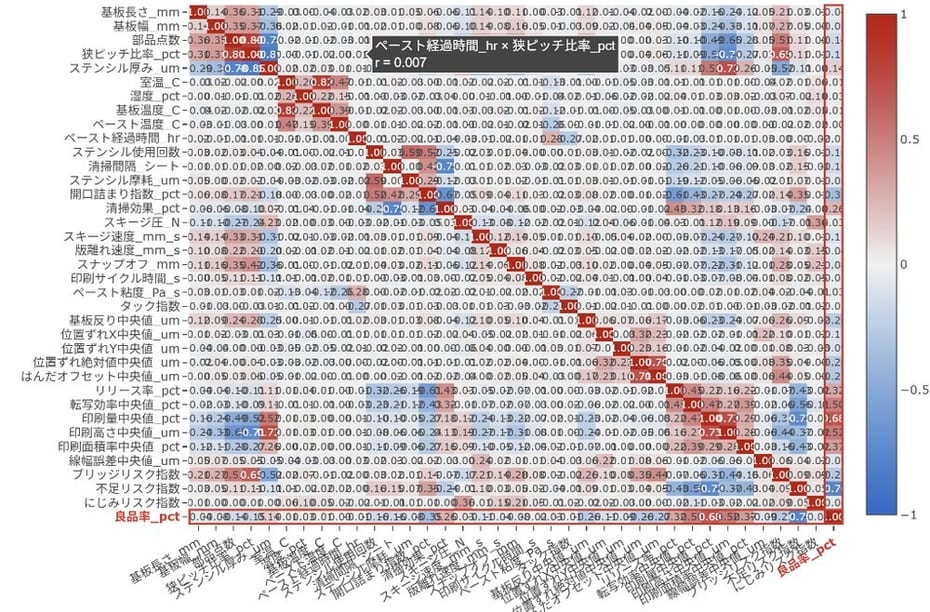
全項目×全項目の
相関を一覧
ホバーで詳細
(r値・散布図)
赤=正相関
青=負相関
波形から、5カテゴリ
33種類の特徴量を切り出す。
センサの生波形1本を、統計・変化・周波数・包絡・過渡の33列のCSVに変換する。
「numpyでピーク検出を…」の議論を、そもそもしなくていい。
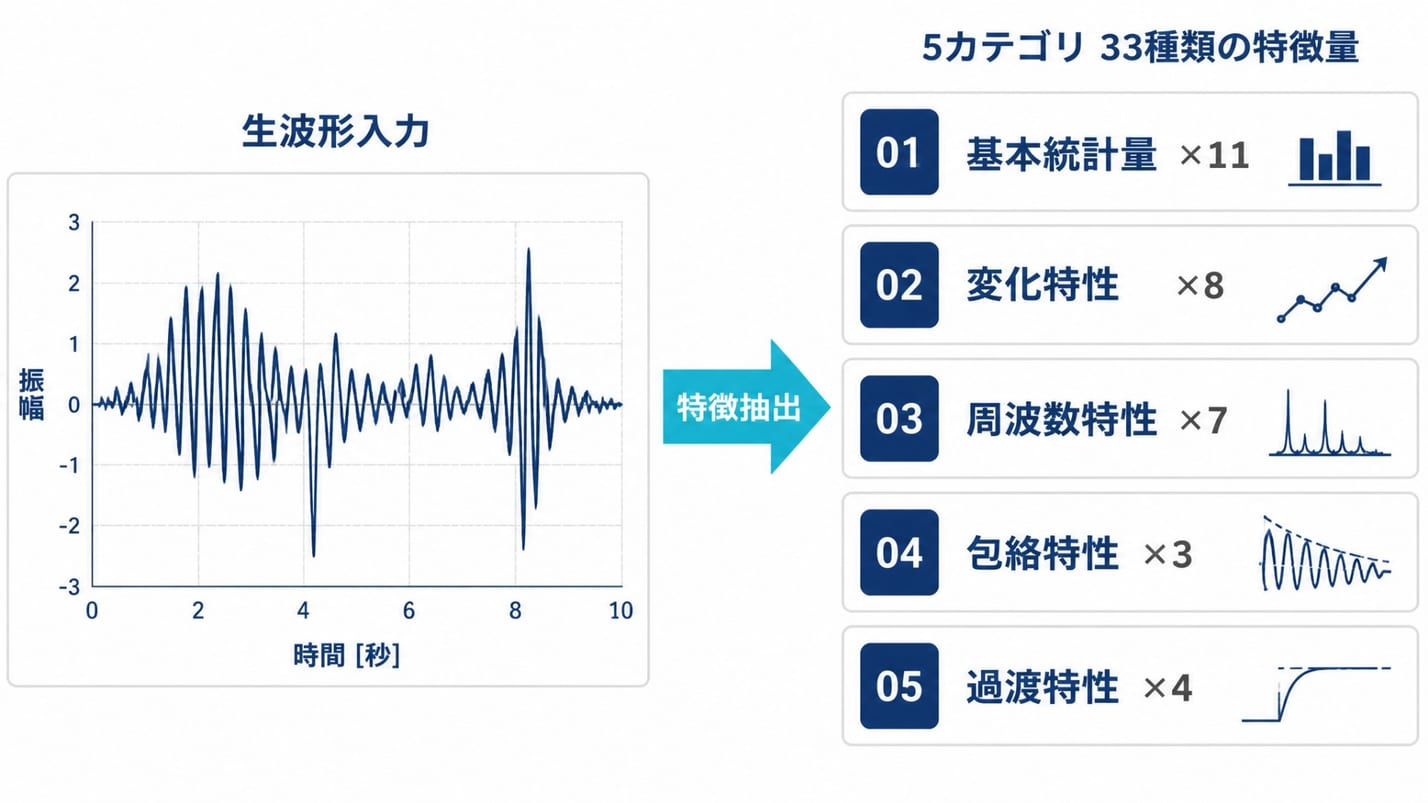
- 最大値/最小値/平均
- 中央値/レンジ/標準偏差
- 実効値(RMS)/波高率
- 3σ/歪度/尖度
- 平均変化量
- 最大変化量
- 平均変化率
- 上昇トレンド比率
- SN比/存在確率
- 基準線との差
- 基準線での存在確率
- 主要周波数
- ピーク強度(dB)
- 帯域パワー
- スペクトル重心
- スペクトル平坦度
- ケプストラムピーク
- 部分オーバーオール ★
- 包絡平均値
- 包絡標準偏差
- 包絡ピーク数
- 立ち上がり時間
- 立ち下がり時間
- 最大変化率
- 応答時間
特徴量はwave列ごとに 〔列名〕_〔特徴量名〕 で出力され、下流の推薦・最適化ブロックへ直接接続される。
学習させる前に、
項目を診断する。
Feature Selection ─ Taguchi-inspired diagnosis before learning
品質工学(タグチ手法)に基づく項目選択 ── SN比・歪度・尖度で、学習前に有意性を診断する。
母集団を条件で絞り込む
学習に使うデータの母集団を条件で絞り込む。上流ブロックの出力から列を選択。
学習に不向きな項目を自動除外
SN比・歪度・尖度で、学習に不向きな項目を自動でふるい分ける。
現場の判断で最終確定
STEP 2のふるい分け結果を確認し、現場の判断で採用・不採用を上書きできる。
ばらつきに強い項目を選ぶ。
S/N = 信号 / ノイズ。ノイズが乗っても壊れない特徴量だけを、学習に渡す。
分布の片寄りを検出。
異常に片側に偏った特徴量は、モデルを歪めるので事前に除外。
分布の尖りを検出。
突発的な外れ値が支配する項目は、汎化性能を落とすので除外。
基準の決め方は、2モード。
マニュアル不要で、直感的な表現で基準をセット。
SN比・尖度の数値を直接入力して微調整。
上流ブロックからの全項目データ/300項目(例)
SN比・歪度・尖度で自動ふるい分け+人の判断で上書き
学習に効く項目のみ/300項目 → 18項目に絞る
学習させる前に、
アルゴリズムを推奨・選択・学習・検証する。
Automated Algorithm Selection ─ 5-step UI Flow before Learning
50種のアルゴリズムを並列で走らせ、推奨スコア順に上位3〜5つを自動選定。
専門家が数日かけて判断していた工程を、5つのUI画面に凝縮する。
欠損率・ユニーク率・型・注意フラグ(定数/外れ値候補)を自動チェック。使う特徴量を選ぶ。
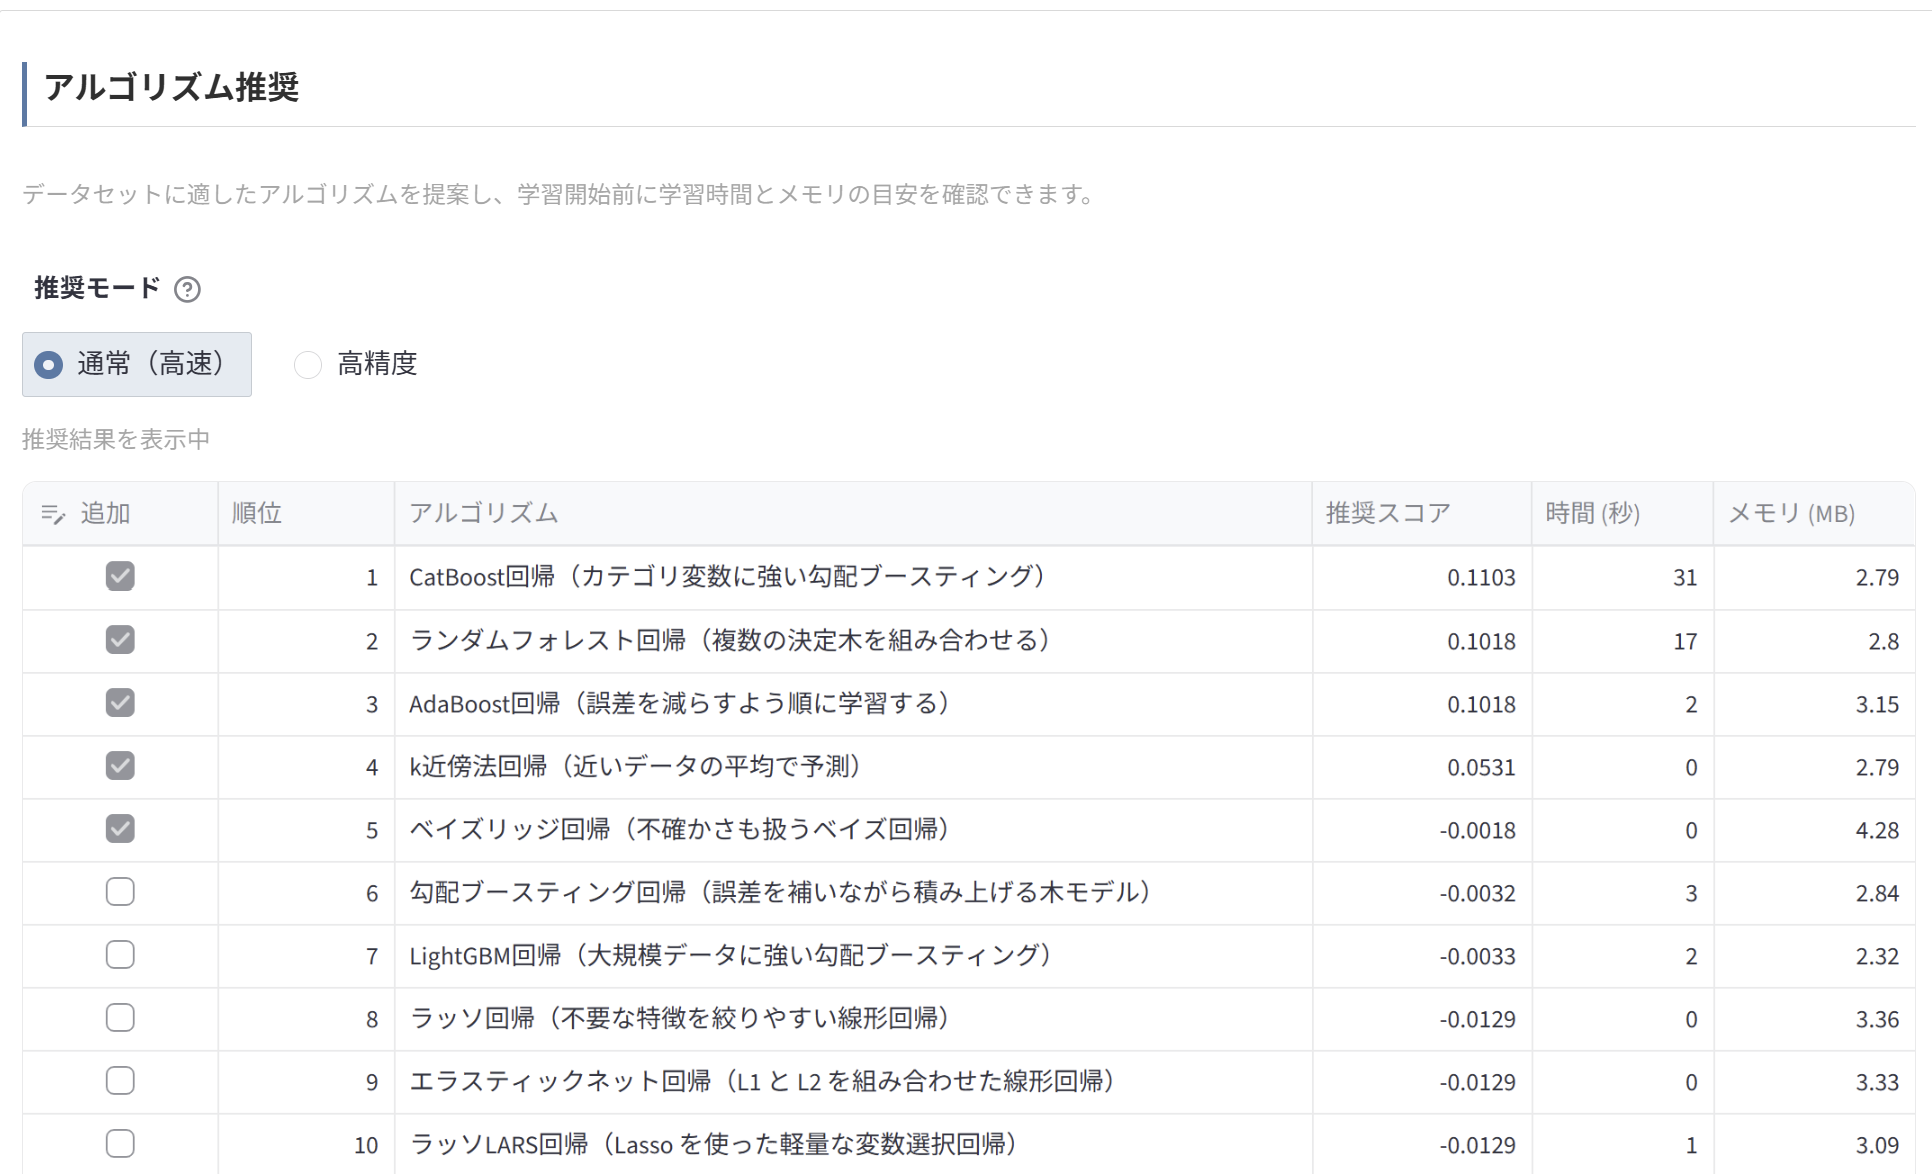
通常(高速)/高精度モードで、50種から推奨スコア順に上位を提示。学習時間・メモリ目安を先に確認。
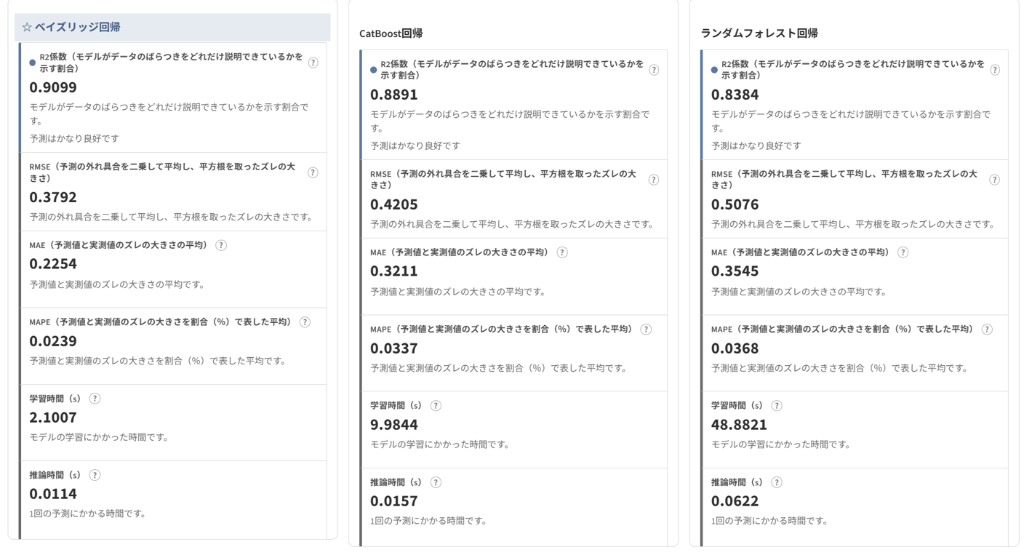
選ばれた3〜5モデルを並列で同時学習。CatBoost・ランダムフォレスト・ベイズリッジ など。(バックグラウンドで実行)
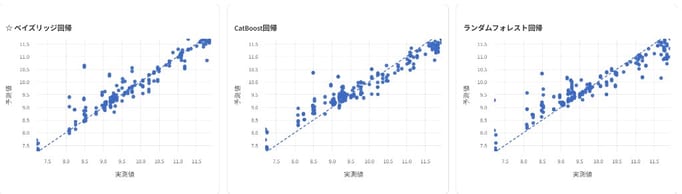
R²・RMSE・MAE・MAPE・学習時間・推論時間で並列比較。数値と予実散布図の両方で確認。
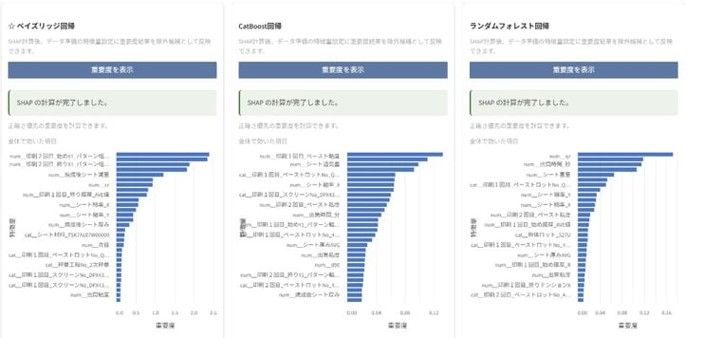
モデルごとに"何が効いたか"を可視化。現場の直感と照らして採否を最終判定。
目的変数(例:良品率)
50種から上位を推奨/並列学習/精度比較/SHAP検証
精度指標/予実プロット/SHAP重要度
50+のアルゴリズムを自動選定、
並列実行で最適解へ。
独自開発のロジックで、アルゴリズムの精度を学習前にスコア化。
欠損率・ユニーク率・型・注意フラグ(定数/外れ値候補)を自動判定。
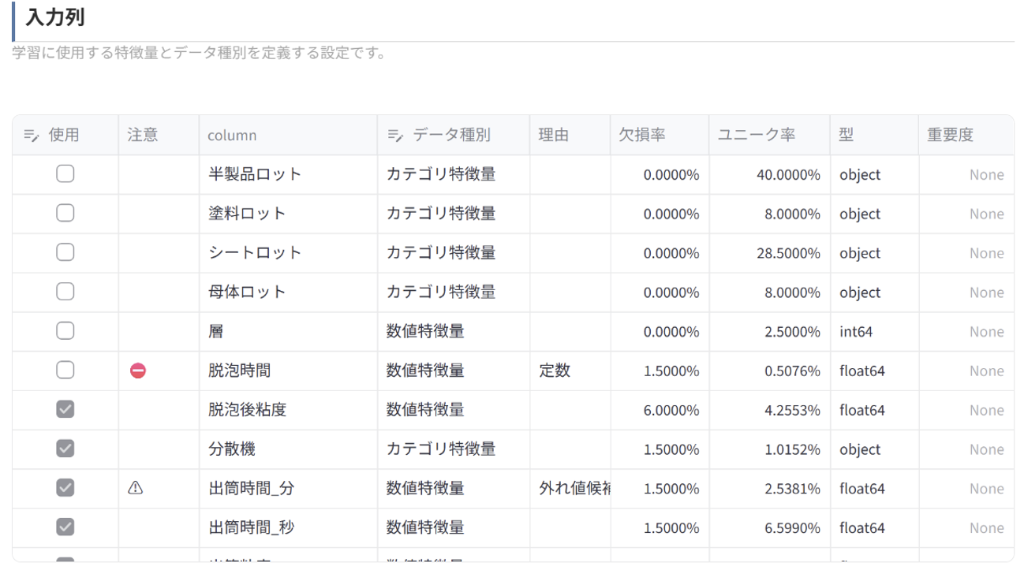
50種から推奨スコア順に上位提示。学習時間・メモリを先に確認。
R² / RMSE / MAE / MAPE / 学習時間 / 推論時間 の6指標。
対角線が完全予測。モデルごとのばらつきを一目で。
モデルごとに特徴量の寄与度を可視化。/現場知と照らして採否を最終判断。
予測で止まるか、
逆算まで踏み込むか。
SFIは予測もする。分類15/回帰19の中からデータに合うモデルを自動推薦・並列学習する。
その高精度な予測モデルの上で、目標値から逆算して、現場が実行可能な条件を返すのがBackcastだ。
従来ツール ── 予測で止まる
歩留 85% になる見込みです。
→ で、何を変える?答えは返らない。
予測は返る。しかし「明日から何を動かすか」は現場任せ。結局、勘に戻る。
- パラメータを人が試行錯誤
- 条件書き換えは職人の手作業
- 「AIは参考」で終わる
SFI ── 予測 + 逆算まで返す
モデル:CatBoost(R²=0.94)/自動選定
歩留 90% にするには、
- 温度 178℃ 前後(現在182℃)
- 脱泡後粘度 750 前後(現在700)
- シート厚み 20.4mm(現在20.3mm)
に変更してください。
→ 明日から動かせる。
予測は現状把握、逆算は改善の答え。SFIはその両方をワンフローで返す。
現状を予測するだけではなく、目標値から現場の条件を逆算する。
解析ツールを、意思決定の道具に変える。それがBackcastの本質。
目標から、
条件セットを組み立てる。
Core 3で自動選定された高精度な予測モデルの上で、目標値と制約を設定して探索する。
ここで重要なのは、探索の基準を何に取るか──SFIは各項目の分布を見て、基準値を自在に切り替えられる。
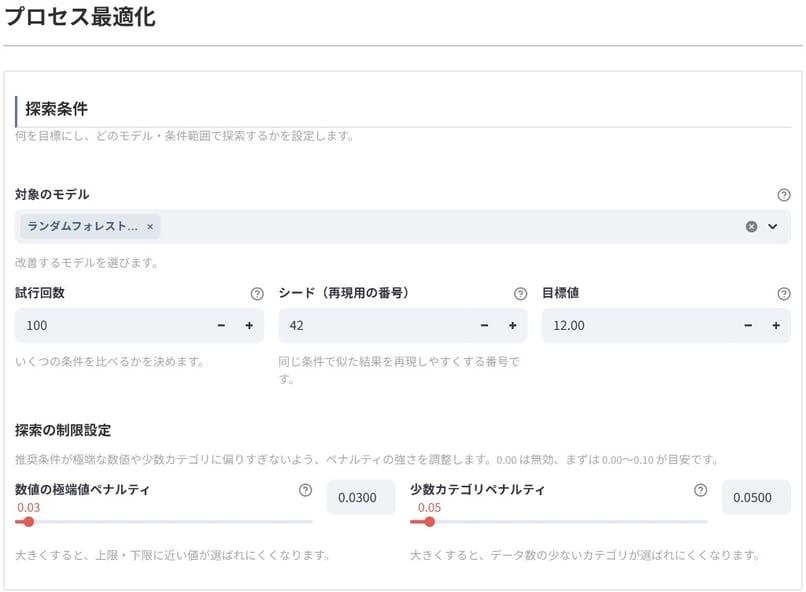
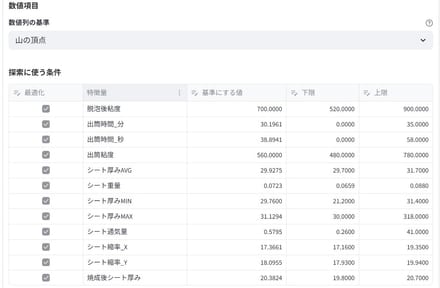
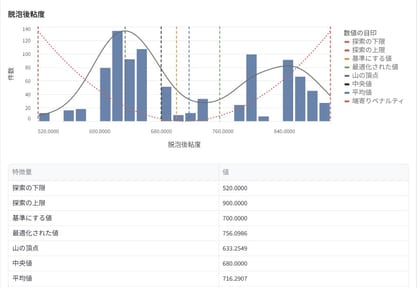
- ・目標歩留 90%
- ・試行回数 1,000回
- ・変数レンジ/ペナルティ
- ・変更禁止パラメータ
- ・温度 178℃
- ・時間 42秒
- ・圧力 0.32MPa
- ── 目標到達確率 92%
プロセス条件提案方法(Backcast)
逆算まで踏み込む。
基準の取り方で、探索の結果は変わる。デフォルトは分布の山の頂点。
実データで最も頻度の高い値。
無難な探索。
統計量を基準にしたい場合に1クリックで切替。
分布を見ながら、現場ノウハウで数値を指定。
レポートを、
プロンプトで組み立てる。
解析結果を、読み手・目的・粒度に応じてプロンプトで指定。SFIが用途に合わせたレポートを組み立てる。
定型3種ではなく、指示の数だけレポートの型がある。
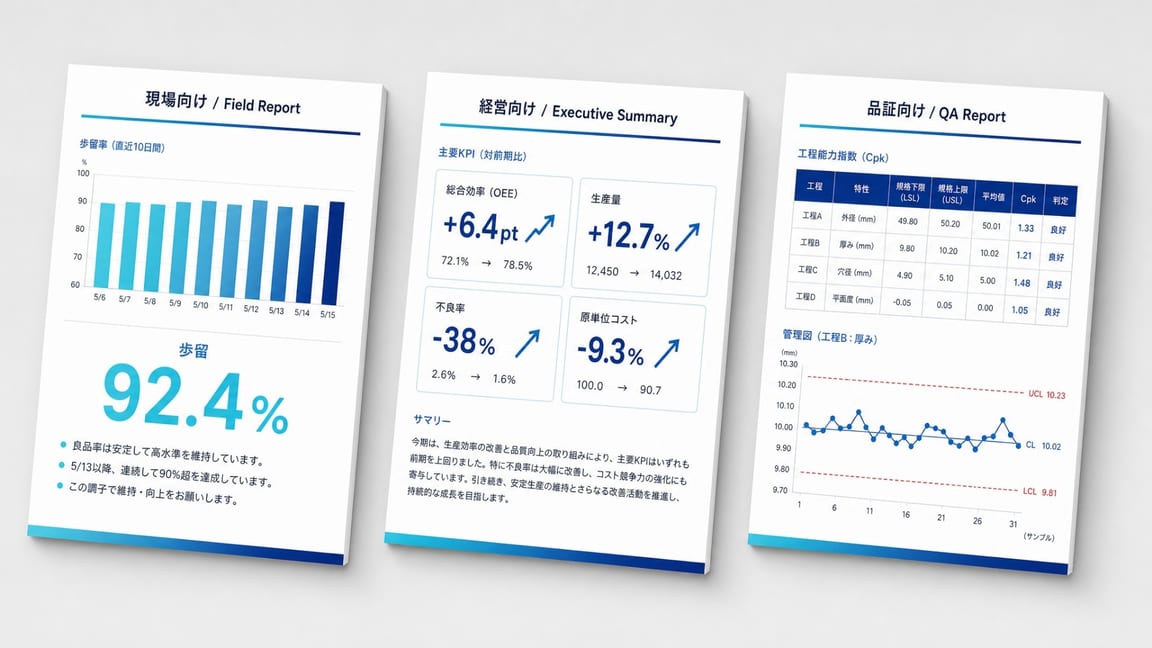
→ 推奨条件・変更点・注意事項を要点だけに絞ったレポート。
→ 歩留改善・段取り時間・原価低減インパクトを金額で提示。
→ 品質検証に必要な指標を漏らさず、監査向け書式で整形。
選択式で、レポートのプロンプトを組み立てる。
読み手(現場/管理職/品証/顧客)・目的(朝礼/稟議/監査/提案)・粒度(要点/詳細)を指定すると、SFIが自動でプロンプトを構築し、解析結果を組み込む。
- PDF(A4/両面)
- PowerPoint(16:9 / A4縦)
- Excel(データ添付)
- Word(監査文書)
5つのステップで、
現場実装まで。
「取り込む → 整える → AIが選ぶ → 目標から逆算 → 現場で動かす」。
各ステップで、入力・所要時間・出力を具体的に。
取り込む
CSV・PLCログ・波形をドラッグ&ドロップ。数百万行でもそのまま。
整える
波形から特徴量を切り出す。300項目から18項目に絞る。
AIが選ぶ
50種を並列で走らせ、精度・速度で比較。SFIが3候補を推薦。
目標から逆算
目標歩留・許容範囲・ペナルティを設定。条件セットが返る。
現場で動かす
条件セットを現場帳票に転記。翌日から新しい条件で運転開始。
数百万行のCSVを、
そのまま扱う。
Apache Arrow + Rust エンジン採用。Python 単体で同じ処理を書いた場合と比べ、5〜7倍の処理速度。
オンプレミス/クラウドを選択可能。
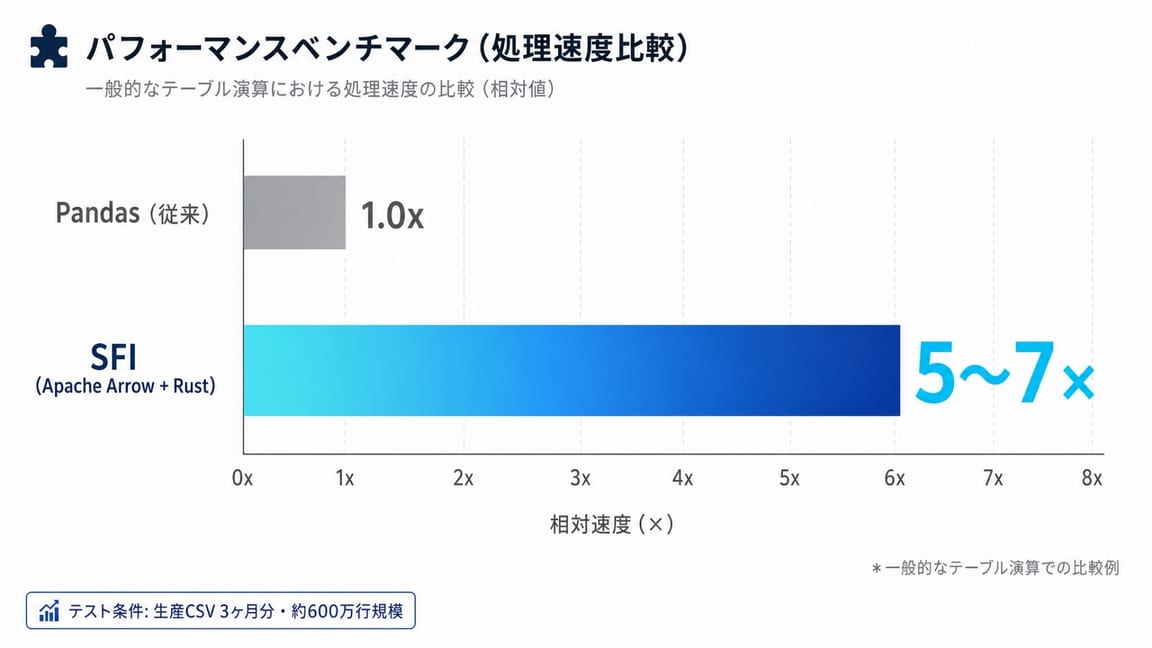
Python 単体実装に対する処理速度/メモリ効率。
数百万行のCSVをそのまま扱えるため、事前サンプリングや分割処理は不要。
"AIを社外に出したくない"に、先回りで応える。
データを外に出さない
オンプレ配置で、生産データが自社内に留まる。
操作ログを残す
誰が・いつ・どの条件で解析したかを全て記録。
権限を分ける
解析者/閲覧者/管理者を役割で分離。
モデルを閉じる
外部APIコール一切なし。学習も推論も社内で完結。
なぜ、Excelでも、Pythonでも、
汎用AutoMLでもないのか。
4 Alternatives ─ 6 Axes ─ Where SFI Stands
製造業でAI導入を検討する時、選択肢は4つある。SFIは「現場で回る」6つの軸で、他とどこが違うのか。
特定製品との比較ではなく、アプローチの類型で示す。
| 比較軸 COMPARISON AXIS |
SPREADSHEETExcelマクロ | IN-HOUSE DEV社内 Pythonチーム | GENERIC AUTOML汎用 AutoML | SI CUSTOM大手SI 個別開発 | VERTYSSFI |
|---|---|---|---|---|---|
| 波形データの処理WAVEFORM | ✕ 実質、扱えない |
△ 自作/再現困難 |
△ 対応外が多い |
○ 個別実装 |
◎ 33種特徴量 標準搭載 |
| 目標から逆算BACKCAST | ✕ 不可能 |
△ 個別実装/時間要 |
✕ 予測止まり |
△ 個別実装 |
◎ 特許出願 2026-116053 |
| 初期費用INITIAL COST | ¥0 + 人件費 |
年 ¥1,500万〜 DS1名 人件費相当 |
¥数百〜数千万 ライセンス + 研修 |
¥数千万〜 個別見積 |
¥0 月額のみ ¥98,000〜 |
| 立ち上げ期間TIME TO FIRST RESULT | 案件都度 属人的 |
3〜6ヶ月 採用+育成込 |
3ヶ月+ 研修必須 |
6ヶ月〜 要件定義から |
6週間 最初の成果まで |
| 現場で運用FIELD OPERABILITY | ○ 属人化リスク |
✕ DSに依存 |
△ 要研修 |
✕ SI依存 |
◎ 現場エンジニアがノーコードで運用 |
| 属人化リスクKEY PERSON RISK | 高作った人依存 | 高DS採用競争 | 中ベンダー依存 | 高SI囲い込み | 低フローが資産として残る |
SFIは、汎用ツールでも
個別開発でもない。
製造業の "型" に、最初から特化。
波形と目的関数が、
標準装備。
初期費用ゼロ、
月額のみ。
現場エンジニアだけで
回る。
特定製品との比較ではなく、4つのアプローチ類型との比較。個別評価は、貴社ご要望に応じPoCで実証可能(6週間・追加費用なし)。
"AIを、現場で回す" ── その一点に、全機能を最適化した。
9ブロック、
目的と機能。
Block Reference ─ Purpose & Function
「解析パイプライン構築」「前処理」「解析・最適化」の3カテゴリ、9ブロック。
各ブロックが「何のために」「何をするか」を、実UIの見た目で示す。
解析対象のデータをSFIに登録。
CSV/DB/サーバー内データを取り込み。
複数期間・ロットを1つのデータに。
同列構成を縦方向に結合(UNION)。
工程別データをキーで横に並べる。
キー結合で横方向に結合(JOIN)。
フローの起点・完了点を明示。
実行順序と完了判定を担う。
生波形を学習可能な特徴量に変換。
5カテゴリ33種の特徴量を自動計算。
欠損・外れ値・型不整合を除去。
欠損補完/外れ値検出/型変換。
モデル投入項目を確定させる。
Y/Xを指定、寄与度で候補を絞る。
最適アルゴリズムを人手なしで選ぶ。
50種超を並列実行、上位を推薦。
目標値を出す条件を逆算する。
目標+制約から条件セットを出力。
4つの質問に答えるだけで、
解析フローが自動で組み上がる。
Block Auto-Generation ─ 4 Questions to a Working Pipeline
プロジェクト作成時、SFIは4つの質問だけを聞く。回答に応じて9種のブロックから必要なものだけを選び、
正しい順序で連結したパイプラインを、その場でプレビュー生成する。
「解析を始める前」に時間を使わない。現場の質問に答えるだけで、走る解析パイプラインが手に入る。
回答をパースする
個品ID有無・工程数・波形有無・変数配置の4軸から、必要な入力レーンを確定する。
ブロックを配線する
9ブロックから必要なものだけを選択、工程並列 → 行連結 → 列連結 → 学習 → AI → 最適化の順に自動連結。
プレビューを返す
「作成する」を押した瞬間、そのままフロー画面へ遷移。編集・差し替えは自由。
ドラッグ&ドロップで組み立てる時間は不要。
連結ミス・順序ミスの余地なし。常に走る前提の構成。
自動生成後もブロック追加・削除・差し替えは自由。
6事例、
ひと目で。
「何を入れて、何が返り、何時間短縮したか」を1行で。詳細はP.23〜P.26へ。
※ 事例は業種・工程レベルでの匿名記述。数値は各案件での改善効果例。
シート成形の歩留まり改善
- 入力
- 脱泡後粘度/温度/シート厚み
- 出力
- 推奨条件セット
- 効果
- 歩留 +6.4pt/段取り −22%
印刷工程の膜厚安定化
- 入力
- 80項目のセンサログ
- 出力
- 効いている22項目+条件
- 効果
- Cpk 1.67/不良 −38%
焼成条件と食感の対応付け
- 入力
- 焼成温度/時間/官能評価
- 出力
- 再現条件セット
- 効果
- 立ち上げ 3週間 → 1.5週間
打錠工程の重量ばらつき低減
- 入力
- 打錠圧/回転数/粉体特性
- 出力
- 重量安定化条件
- 効果
- 重量σ 30%改善/検査 −18%
反応槽温度プロファイル最適化
- 入力
- 温度時系列/滴下速度
- 出力
- 収率最大化プロファイル
- 効果
- 収率 +4.2pt/副生 −21%
締結トルクと気密不良の因果解析
- 入力
- 締結トルク波形/部品ロット
- 出力
- 効く要因ランキング
- 効果
- 気密不良 −62%
シート成形の、
歩留まり改善。
脱泡後粘度のばらつきが、シート厚みと歩留まりに直結。
「粘度700が良いか、900が良いか」の判断が熟練者依存。日毎の湿度・原料ロット差の影響で日次歩留が±8pt揺れる。 ライン停止コストは1時間あたり数十万円規模。
- 入力
- 脱泡後粘度/原料温度/シート厚み/ライン速度/湿度 ── 全120項目
- 処理
- 波形抽出 → 学習項目選択(120→14項目)→ AI自動選定(推奨:LightGBM)→ Backcastで条件セット生成
- 出力
- 脱泡後粘度 750 前後/原料温度 78℃/シート厚み 20.4mm ── 推奨条件セット
月次平均歩留の改善。
金額換算で年間数千万円規模。
条件出し試行回数の減少。
ライン切替が速くなる。
テーマ選定から現場実装まで。
Week 1にキックオフ。
「粘度は感覚で 700 を狙っていたが、SFIが返した 750 を試したら、翌日から歩留まりが上がった。 納得感があるのは、『なぜ750なのか』の要因効果図が付いていたから。」
印刷工程の、
膜厚安定化。
80項目のセンサログを持ちながら、Cpkが1.0を下回る。
塗工速度・粘度・温度・湿度・張力など80項目を記録。しかし「どれが膜厚に効くか」の合意が取れず、 日々の運転条件はベテラン判断に依存。膜厚分布のCpkは平均0.9前後。
- 入力
- センサログ 80項目(塗工速度/粘度/温度/湿度/張力 他)+膜厚実測
- 処理
- 学習項目選択(80→22項目)→ AI自動選定(推奨:CatBoost)→ Backcastで膜厚安定条件を組み立て
- 出力
- 塗工速度/粘度/温度/湿度の推奨レンジ ── 品種切替時の条件出しをテンプレ化
平均0.9 → 1.67 へ改善。
初期は目標1.33を上回る水準。
品種切替の立ち上げが速くなる。
多品種ラインでは効果大。
膜厚外れによる工程内不良の削減。
再塗工工数が減る。
「80項目のセンサログを揃えてから3年、活用できていなかった。 『効いていない項目』が58項目もあったと数字で示されて、初めて議論が前に進んだ。」
食品と医薬品。
「再現」の話。
官能評価と物理量、あるいは打錠圧と粉体特性。「同じ結果を、別のロットで再現する」がテーマ。
※匿名事例
焼成条件と食感の対応付け
新製品の焼成条件が、パイロット試作と量産で再現しない。
官能評価(サクサク感/しっとり感)と焼成温度・時間・生地水分の対応が取れず、量産立ち上げで条件を再調整。3週間掛かることも。
入力:焼成温度/時間/水分/官能評価スコア。
処理:学習項目選択 → AI推薦 → Backcast。出力:再現条件セット。
官能を数値と紐づけたことで、味の再現が「勘」ではなく「レシピ」になった。
打錠工程の重量ばらつき低減
打錠重量のロット間ばらつきが規格ぎりぎり。
打錠圧・杵回転数は制御しているが、原料粉体の流動性・水分・粒度が日毎に変わり、重量σが拡大。全数検査工数の増大が課題。
入力:打錠圧/回転数/粉体特性(流動性・粒度)/環境。
処理:AI推薦 → Backcast。出力:粉体特性別の推奨レシピ。
粉体ロット差ごとに条件を切り替える運用に切り替え。「同じ条件で回す」ではなく「変えるべき時に変える」へ。
化学と組立。
「因果」の話。
連続プロセスと離散プロセス。共通するテーマは「何が本当に効いているのか」を数値で示すこと。
※匿名事例
反応槽温度プロファイル最適化
収率と副生成物のトレードオフを、どこで切るか。
反応槽の温度プロファイル・滴下速度・撹拌強度が収率に効くが、上げすぎると副生成物が増える。ベテランのプロファイルは属人化。
入力:温度時系列/滴下速度/撹拌/収率/副生量。
処理:波形抽出 → AI推薦 → Backcast(多目的最適化)。
出力:収率-副生の最適プロファイル。
多目的Backcastで、収率と副生の両立点を数値で提示。「上げすぎない温度」の閾値が言語化された。
締結トルクと気密不良の因果解析
気密不良の再発。トルク基準は満たしているのに漏れる。
締結トルクは基準内。しかし部品ロット・作業者・締結順序の組み合わせで気密不良が再発。原因が特定できず対策が場当たり的に。
入力:締結トルク波形/部品ロットID/作業者/締結順序/気密試験結果。
処理:波形抽出+要因分析。
出力:効く要因ランキング+制御ポイント。
本当に効いていた要因は「締結順序」と「立ち上がり波形の傾き」だった。トルク値そのものではなかった。
業種 × テーマ、
適合マップ。
7業種 × 5テーマの適合度を、記号で示す。
◎:最相性 / ○:有効 / △:条件により有効。
| 業種 \ テーマ | 歩留まり改善 | 不良率削減 | 段取り短縮 | 消耗品交換最適化 | 熟練者判断の見え化 |
|---|---|---|---|---|---|
| フィルム・シート | ◎ | ◎ | ○ | △ | ◎ |
| 印刷・コーティング | ◎ | ◎ | ◎ | ○ | ○ |
| 食品 | ○ | ◎ | ◎ | △ | ◎ |
| 医薬品 | ◎ | ◎ | ○ | ○ | ○ |
| 化学(バッチ) | ◎ | ○ | ○ | △ | ◎ |
| 自動車部品(組立) | ○ | ◎ | ◎ | ○ | ○ |
| 金属加工(機械) | ○ | ○ | ◎ | ◎ | △ |
※ 本表はSFIの技術的相性・適合度を示すもので、導入実績を意味しません。 個別プロジェクトの成否は、データの品質・整備状況・現場体制に依存します。事前ヒアリングで適合可否を確認します。
6週間で、
最初の成果へ。
1テーマ・1ラインから。
Week 1 の意思決定から Month 2+ の継続改善まで、5ステップで示す。
テーマ選定
候補工程から1つ選ぶ。適合度と着手容易性で優先付け。
データ棚卸し
CSV/PLC/検査データの所在と粒度を確認。欠損の傾向も把握。
導入・解析
SFIをセットアップ。ブロックをつなぎ、AIを推薦させ、Backcastで条件を組み立てる。
現場実装
現場帳票に条件を反映。試験運転で歩留・不良率をKPIとしてモニタ。
継続改善
新ロットで再学習。テーマ数を段階的に拡張(同ラインで別品種/別ライン)。
ここが速いから、次のテーマがすぐ始められる。
導入前に、確かめておきたいこと。
SFIを検討される際、多くのお客様からご相談いただく6つの問い。
先に回答をお示しします。データの扱い、現場適合、導入コスト——不安は前もって、なくしておきたい。
データを社外に出せない。対応できますか?
オンプレミス/プライベートクラウド/エッジ、3つの配置方式を選択可能。データは一切社外に出さない構成が組める。
現場で使いこなせるか心配です。
ノーコード。4つの質問に答えるだけで解析パイプラインが自動生成される。現場エンジニアだけで運用可能。
以前PoCで成果が出なかった。
6週間で最初の成果。成果が出なければ継続不要。初期費用ゼロなので、失敗時の損失は月額のみ。
データが揃っていなくても大丈夫?
揃っていないから、SFIがある。前処理・クレンジング・特徴抽出が9ブロックの標準機能。CSVがあれば十分。
既存システムと共存できますか?
止めない。既存PLC/MES/SCADAと並行で動く設計。段階導入・1ライン単位から開始できる。
費用対効果の見積もりは?
月額¥98,000〜。歩留1%改善で回収する規模の投資。個別開発(数千万円)と桁が違う。
不安を残さずに、次の一手へ。
個別のテーマは、6週間PoCで実証させていただけます。
月額 ¥98,000で、2 PCライセンス。
1テーマ・1ラインから。初期費用不要。1契約で2 PCまで利用可能——
現場・オフィス・PoC現場の2地点並行利用を想定した標準構成。
- 2 PC ライセンス込み
- 全搭載AIアルゴリズム
- Backcast最適化
- レポート自動生成
- 初期費用不要
- アップデート込み
製造業DX人材の平均年収レンジ中央値。
採用まで6〜12ヶ月、離職リスクあり。
年間ベース——DS人件費の 約1/7。
翌週から使える。離職リスクゼロ。
3 PC目以降の追加
標準2 PCに加え、ユーザ増員・複数ライン展開に応じて追加可能。
伴走支援
Vertysチームがテーマ設計から現場実装まで並走。初回テーマ推奨。
オンプレ配置
工場内サーバへの配置。データを社外に出さない構成に対応。
回帰アルゴリズム、19種。
SFIは全19種を並列実行し、精度・速度・説明性のバランスで3候補を推薦する。
| ALGORITHM | 大量データ | 高次元特徴 | 説明性 | 精度 | 速度 | 外れ値耐性 | カテゴリ変数 |
|---|---|---|---|---|---|---|---|
| 01線形回帰 | ◎ | △ | ◎ | △ | ◎ | × | × |
| 02リッジ回帰 | ◎ | ○ | ○ | ○ | ◎ | △ | × |
| 03ラッソ回帰 | ◎ | ◎ | ◎ | ○ | ◎ | △ | × |
| 04ElasticNet | ◎ | ◎ | ○ | ○ | ○ | △ | × |
| 05SVR | △ | ○ | △ | ○ | △ | ○ | × |
| 06決定木回帰 | ○ | ○ | ◎ | ○ | ◎ | ○ | ◎ |
| 07ランダムフォレスト | ◎ | ◎ | ○ | ◎ | ○ | ◎ | ◎ |
| 08勾配ブースティング | ◎ | ◎ | ○ | ◎ | ○ | ○ | ○ |
| 09XGBoost 回帰 | ◎ | ◎ | ○ | ◎ | ◎ | ○ | ○ |
| 10LightGBM 回帰 | ◎ | ◎ | ○ | ◎ | ◎ | ○ | ◎ |
| 11CatBoost 回帰 | ◎ | ○ | ○ | ◎ | ○ | ○ | ◎ |
| 12KNN 回帰 | △ | × | ○ | ○ | △ | × | △ |
| 13MLP 回帰 | ○ | ○ | × | ○ | △ | △ | × |
| 14ガウス過程回帰 | × | △ | ○ | ◎ | × | ○ | × |
| 15ベイズ線形回帰 | ○ | △ | ◎ | ○ | ○ | ○ | × |
| 16PLS 回帰 | ○ | ◎ | ◎ | ○ | ◎ | △ | × |
| 17主成分回帰 | ○ | ◎ | ○ | ○ | ◎ | △ | × |
| 18等方回帰 | ○ | × | ◎ | ○ | ◎ | ○ | × |
| 19ロバスト回帰 | ◎ | △ | ◎ | ○ | ◎ | ◎ | × |
→ LightGBM / XGBoost
→ リッジ / PLS 回帰
→ ロバスト / RandomForest
分類アルゴリズム、15種。
SFIはタスク種別を自動判定し、精度・クラス不均衡耐性・説明性で推薦を返す。
| ALGORITHM | 大量データ | 高次元特徴 | 説明性 | 精度 | 速度 | クラス不均衡 | カテゴリ変数 |
|---|---|---|---|---|---|---|---|
| 01ロジスティック回帰 | ◎ | △ | ◎ | △ | ◎ | △ | × |
| 02SVM | △ | ○ | △ | ○ | △ | ○ | × |
| 03決定木 | ○ | ○ | ◎ | ○ | ◎ | ○ | ◎ |
| 04ランダムフォレスト | ◎ | ◎ | ○ | ◎ | ○ | ○ | ◎ |
| 05勾配ブースティング | ◎ | ◎ | ○ | ◎ | ○ | ○ | ○ |
| 06XGBoost | ◎ | ◎ | ○ | ◎ | ◎ | ◎ | ○ |
| 07LightGBM | ◎ | ◎ | ○ | ◎ | ◎ | ◎ | ◎ |
| 08CatBoost | ◎ | ○ | ○ | ◎ | ○ | ◎ | ◎ |
| 09KNN | △ | × | ○ | ○ | △ | △ | △ |
| 10ナイーブベイズ | ◎ | ○ | ◎ | △ | ◎ | ○ | △ |
| 11LDA (線形判別) | ○ | △ | ◎ | ○ | ◎ | △ | × |
| 12QDA (二次判別) | ○ | △ | ○ | ○ | ○ | △ | × |
| 13MLP (多層パーセプトロン) | ○ | ○ | × | ○ | △ | △ | × |
| 14AdaBoost | ○ | ○ | ○ | ○ | ○ | ○ | ○ |
| 15Extra Trees | ◎ | ◎ | ○ | ○ | ◎ | ○ | ◎ |
→ CatBoost
→ LightGBM / XGBoost
→ ロジスティック回帰 / 決定木
異常予知5種と、クラスタリング11種。
品質工学ベースの MT法 から密度ベースの HDBSCAN まで——現場で使い分ける16種。
アイソレーションフォレスト
木構造で分離しやすさから異常度を返す。高次元・大量データに強い。
LOF (局所外れ値)
近傍点との密度差で異常度を返す。局所的な外れ値検出に強い。
ワンクラスSVM
正常データの範囲を境界で囲む。少数の異常ラベルしかない状況で有効。
MT法 (マハラノビス)
品質工学ベース。正常空間からの距離で異常度を返す。説明性が高い。
SGD ワンクラスSVM
オンライン学習版。ストリーミングデータでのリアルタイム検知向け。
k-means
最も基本。事前にクラスタ数を指定。速い。
ミニバッチ k-means
大規模データ向けの高速版。近似解。
二分 k-means
階層的に2分割を繰り返す。安定性が高い。
BIRCH
木構造で階層的にクラスタを構築。省メモリ。
GMM (混合ガウス)
確率分布ベース。所属確率が返る。
ベイズ GMM
クラスタ数を自動決定。事前分布を活用。
DBSCAN
密度ベース。クラスタ数不要。ノイズ検出可。
HDBSCAN
DBSCANの階層版。密度が異なるクラスターに対応。
OPTICS
DBSCANの拡張。パラメータ感度が低い。
スペクトラル
グラフラプラシアンで非線形クラスタに強い。
階層凝集
下から順にマージ。デンドログラムで可視化。
→ k-means / GMM
→ DBSCAN / HDBSCAN
→ 階層凝集 / スペクトラル
まずは、6週間で最初の成果を。
SFIは1テーマ・1ラインから始められます。初期費用ゼロ、月額¥98,000〜。
カタログのダウンロード、資料請求、または直接お問い合わせください。